Jarby Jessid Cosme
Hoja de vida EN

Jarby Jessid Cosme

Ingeniero de software e IA. Soy el responsable de la IA que atiende el chat de soporte del ERP de SIESA, unas 1.000 conversaciones al día.

Ahora
Opero el RAG de soporte de SIESA en producción, 15 módulos del ERP
Construyendo
El triage en línea que será el primer contacto de todos los clientes
Busco
Un cargo remoto de tiempo completo, desde Cali, GMT-5

Perfil

Llevo siete años haciendo software. Primero full-stack en .NET y, desde 2025, la IA del soporte al cliente de SIESA, uno de los ERP más grandes de Colombia.

Me gusta hacerme cargo de un sistema desde la primera mirada a los datos hasta el día en que corre sin mí. En SIESA eso fue leer 90 días de chats, llevarle un caso de negocio a la dirección, construir el motor, salir a producción y operarlo desde entonces. El lenguaje es el que pida el sistema. Sobre todo Python, C# y TypeScript, con SQL en todas partes.

También enseño. Formé a 16 personas y acompañé a 3 equipos mientras empezaban a usar IA en su trabajo.

Hoy
Único responsable técnico de la plataforma de IA de soporte, SIESA, desde mayo de 2026. Desarrollador de software en SIESA desde marzo de 2022.
Antes
Desarrollador full-stack independiente, 2019 a 2022. Seis aplicaciones web para pymes colombianas, entre ellas una tienda con PayU que vendió más de US$25 mil el primer año.
Stack
Python, FastAPI, C# y .NET 8, TypeScript, React, SQL Server, PostgreSQL con pgvector, AWS Bedrock, LangGraph, n8n.
Por mi cuenta
Tocaturno, mi propio producto, además de clases de IA y automatizaciones para clientes.
Estudios
Ingeniería de Sistemas, UNAD, en curso hasta 2027. Tecnólogo en Análisis y Desarrollo de Sistemas, SENA, 2022.
Idiomas
Español nativo. Inglés B2, que uso todos los días en el trabajo.
La historia del RAG

El chat de soporte de SIESA funcionaba con un chatbot de terceros que nadie podía auditar. Lo reemplacé por un motor que es de la empresa y que se puede medir. Hoy atiende unas 1.000 conversaciones al día.

Empezó por los datos

Saqué 90 días de conversaciones de producción, 55.350 chats y cerca de 964 mil mensajes, y leí lo que de verdad vivían los clientes. No había forma de saber si una respuesta era correcta. El modelo, la búsqueda y las citas eran del proveedor, así que una política de no inventar no se podía hacer cumplir desde afuera. Y el peor momento llegaba después del bot, cuando el cliente pedía una persona y el traspaso se quedaba quieto.

Con eso armé un caso de negocio para la dirección, con seis decisiones ordenadas por impacto y costo. La principal fue construir un motor propio y arreglar el traspaso al mismo tiempo.

El motor

  • Sin framework en el camino de cada pregunta

    Python y FastAPI directo contra la API del modelo, para poder rastrear cada milisegundo y cada token.

  • Claude en AWS Bedrock

    SIESA ya estaba en AWS, así que la facturación y los permisos quedaron en la cuenta que ya tenía. Sonnet responde, Haiku reescribe las preguntas de seguimiento y lee las páginas escaneadas.

  • Buscar amplio, reordenar fino

    Búsqueda en pgvector filtrada por módulo del ERP y luego Cohere Rerank deja los cinco pasajes que lee el modelo.

  • Revisada antes de salir

    Cada cita tiene que estar en lo que se recuperó. Un número que no aparece en las fuentes pasa el chat a una persona.

  • Reglas antes del modelo

    Unas 170 reglas fijas atienden saludos, riesgos y pedidos de hablar con alguien antes de cualquier llamada al LLM.

  • El mismo contrato del bot anterior

    El portal de soporte no cambió, así que pasar al motor nuevo y devolverse eran operaciones de rutina.

Salir a producción, dos veces

  1. Modo sombra772 conversaciones reales, sin mostrar las respuestas. Un juez aparte prefirió el motor nuevo el 44% de las veces y el anterior el 40%.
  2. CambioLos clientes siguieron con la misma ventana de chat.
  3. ReversaVolvimos al proveedor por una queja de la mesa de soporte.
  4. Cambio otra vezCon la causa raíz corregida.
  5. 15 módulos del ERPUnas 1.000 conversaciones al día. Con informes a la dirección y al CEO.

Lo que cambió

40,2%32,7%

Escalación a humano por chat en Nómina, el módulo con más volumen. Estadísticamente significativa, p = 0,0005.

6,95%0,25%

Respuestas que mandan al cliente a contactar a soporte.

71,6%89,6%

Respuestas correctas entre cortes de evaluación, calificadas por un juez LLM validado con personas.

-16%

Costo por turno después de agregar caché de prompts.

30%64%

CSAT de servicio al cliente después de rediseñar el traspaso a los agentes.

La solución estaba en el contenido

La búsqueda híbrida parecía la mejora obvia. La construí, la medí dos veces con preguntas reales de clientes y la apagué. Recuperó 0 de 5 casos que fallaban, y todas las variantes de búsqueda que probé quedaron a menos de 3,6 puntos entre sí.

Entonces el esfuerzo se fue a los documentos. Reprocesé 1.027 con OCR multimodal y monté un ciclo de curación donde los agentes aprueban unas 150 respuestas nuevas por semana, desde una consola que usan 44 cuentas de agentes.

Desde entonces todo cambio sale igual. Un golden set por módulo calificado por un juez LLM, una repetición A/B sobre trazas reales y una prueba de significancia antes y después. Ese método lo rehíce en abierto como rag-eval-bench.

La plataforma es de SIESA. Las cifras salen de informes del proyecto a la dirección, de julio a octubre de 2026. La arquitectura la puedo explicar en detalle en una entrevista.

Proyectos

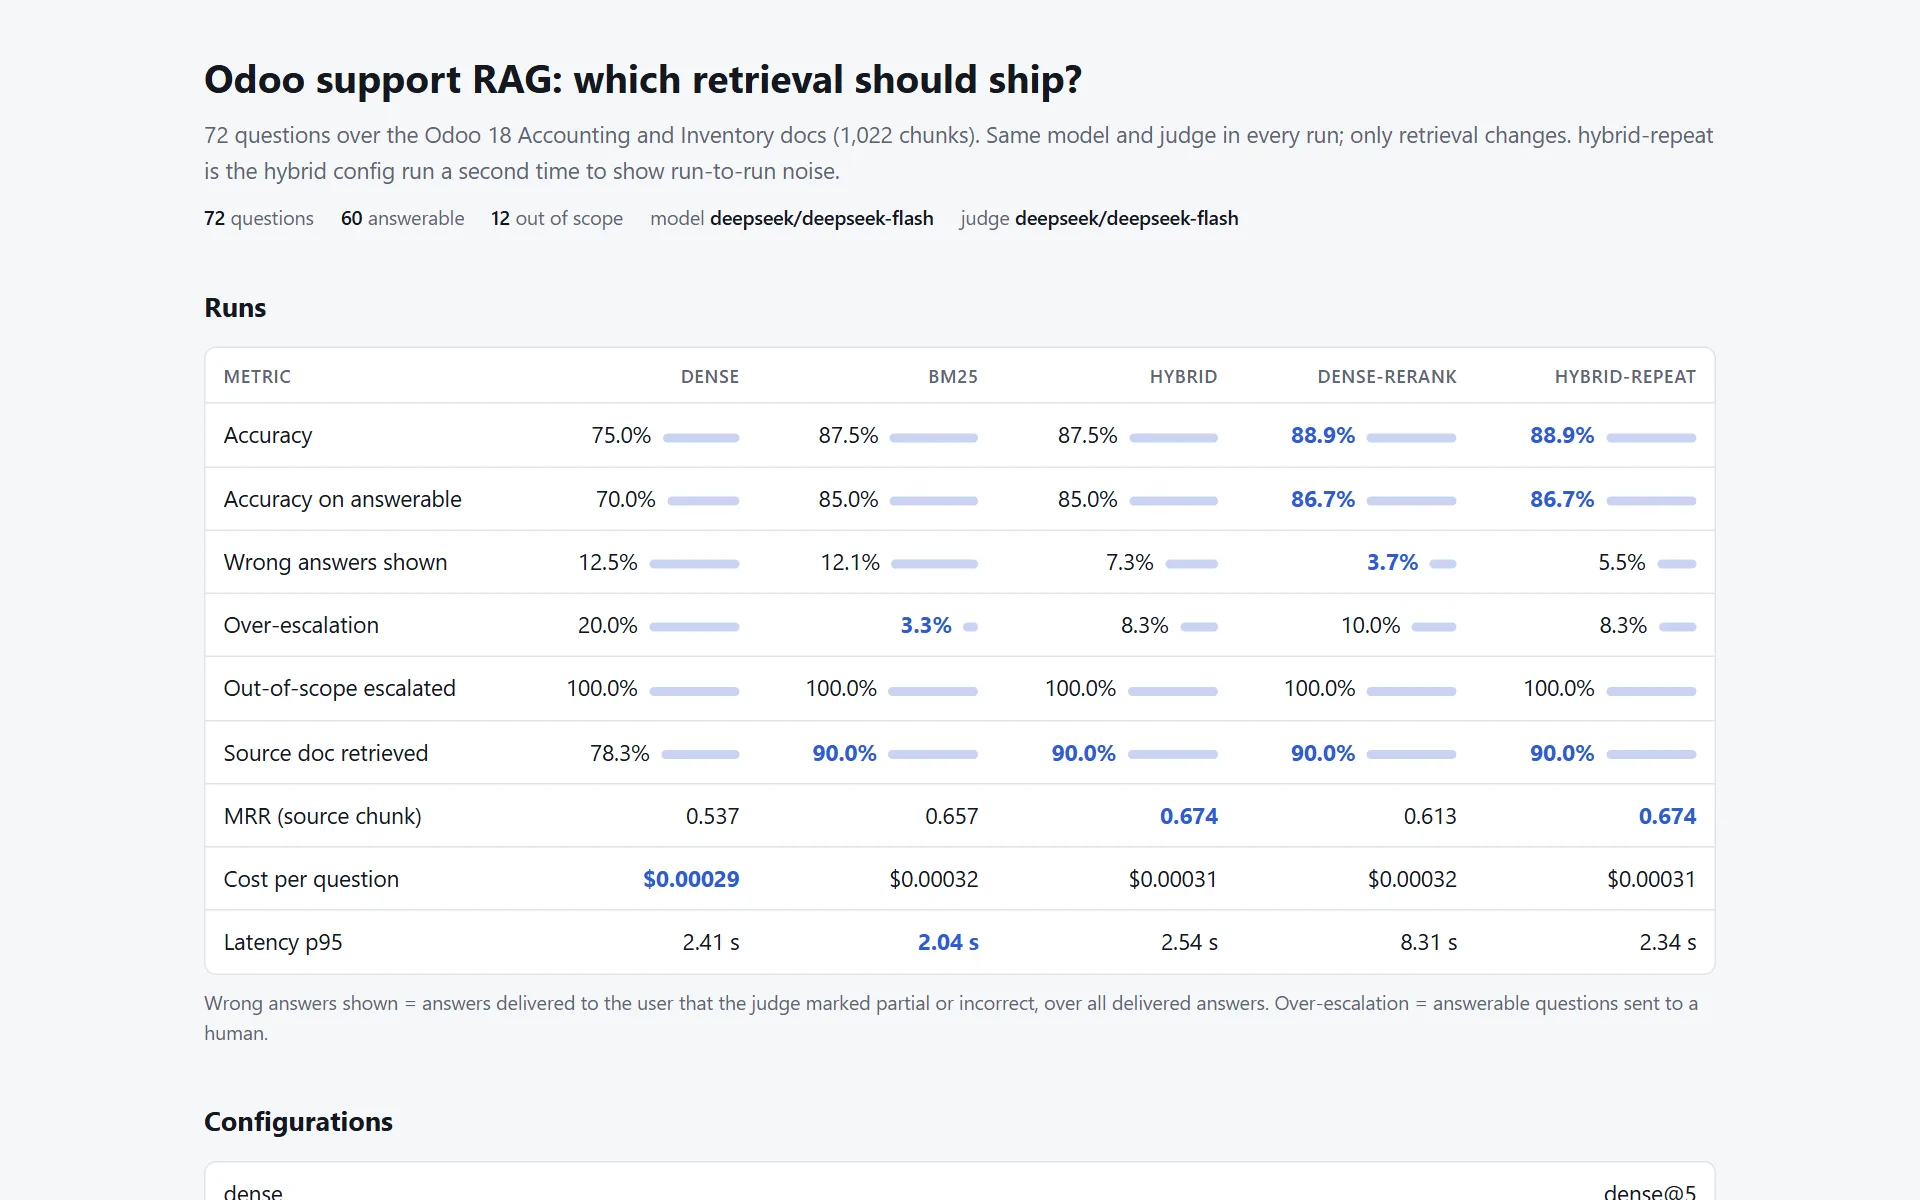
Informe de rag-eval-bench que compara cinco configuraciones de búsqueda en exactitud, respuestas erradas mostradas, escalación, costo y latencia.
Código público

rag-eval-bench

Un banco de pruebas que decide si un cambio a un RAG sale a producción. Tiene un golden set con preguntas que la documentación no responde, un juez LLM, un validador que detecta citas y números inventados y una prueba de McNemar pareada detrás de una compuerta en CI. Corre sobre la documentación pública de Odoo 18.

Lo que encontró. La búsqueda híbrida le ganó a la densa por 12,5 puntos, p = 0,02. Un reranker sumó 1,4 puntos y subió la latencia p95 de 2,5 s a 8,3 s, así que no sale.

  • Python
  • BM25 + RRF
  • LLM-as-judge
  • GitHub Actions
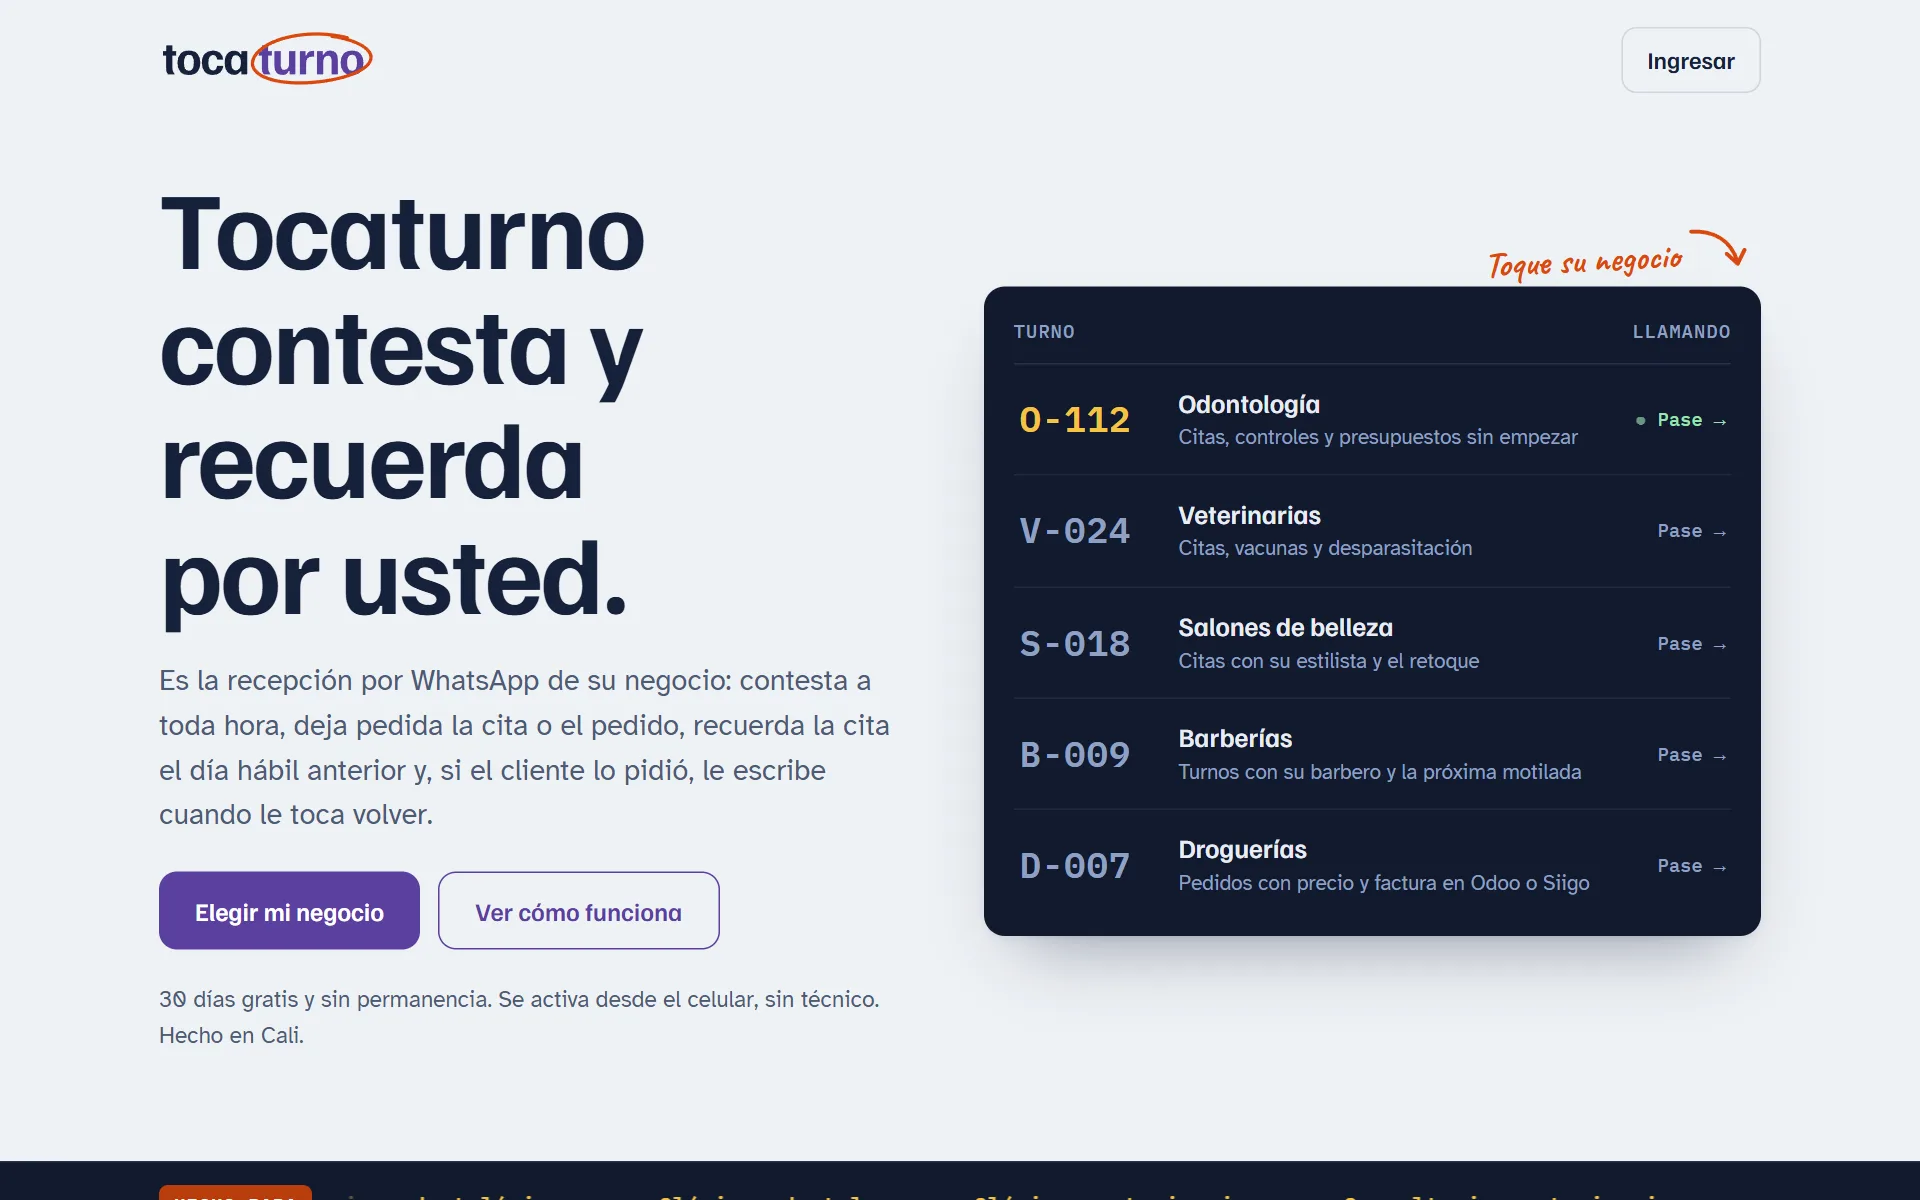
Página de inicio de Tocaturno, una recepción por WhatsApp para consultorios, veterinarias, salones, barberías y droguerías.
En línea

Tocaturno

Mi propio producto. Una recepción por WhatsApp para negocios que trabajan con citas. Contesta a toda hora con plantillas que aprueba el dueño, agenda en los espacios libres, manda recordatorios y le pasa a una persona las conversaciones delicadas.

  • WhatsApp
  • LLM
  • Agenda
41,1%

Las veces que la atribución del bot anterior coincidió con una auditoría ticket por ticket. Por esa brecha existe Jarvis.

En sombra

Jarvis

Un juez LLM diario que lee cada conversación de soporte y decide quién la resolvió, la IA, un agente o nadie, con la misma regla para los dos. Al cierre también tipifica el ticket y reemplaza al bot anterior.

En sombra desde el 21 de octubre, a unos US$0,002 por chat. Reescribí su motor de cierre en LangGraph con jueces en paralelo, checkpoints en PostgreSQL y pausas para revisión humana.

  • Claude Haiku
  • LangGraph
  • Power BI
  • n8n
Interno de SIESA

Lo que sigue en la plataforma de soporte

Dos piezas que se montan sobre el RAG. Una está en construcción y la otra está diseñada para más adelante.

En construcción

Triage en línea

Hoy el cliente tiene que escoger un módulo del ERP antes de empezar el chat, y ahí empieza el peloteo entre canales. El triage pasa a ser la única entrada. Entiende el problema, revisa los tickets abiertos del cliente y manda el caso al RAG o a un agente de L1, L2 o L3 con un resumen, para que nadie empiece de cero.

ClienteEscribe el problema con sus palabras
luego
TriageClasifica el pedido y revisa los tickets abiertos
lo manda a
RAG
L1
L2
L3

Antes de prometer nada calculé el techo con datos, unos 6 puntos menos de escalación.

Diseñado, para más adelante

RAG v2, herramientas sobre los sistemas del cliente

Hoy el RAG explica la solución y el cliente la aplica. La segunda versión la ejecuta en la instalación del cliente, un reinicio de servicio o una actualización, y cada acción tiene su propio nivel de permiso.

Problema del clienteLlega por el chat
luego
El RAG encuentra la soluciónEn la documentación, como hoy
luego
Permiso para esa acciónCada acción tiene su nivel
luego
Se ejecuta en el sistema del clienteReiniciar un servicio, aplicar una actualización

El diseño está terminado. La construcción viene más adelante.

Trabajos más pequeños

Pipeline de indicadores de servicio

SIESA

Reemplacé una exportación manual con Excel y nueve scripts SQL, que alguien corría dos o tres veces al día, por un pipeline desde la API de Freshdesk hasta Power BI. Comparado con la carga manual, 9.607 filas contra 9.606.

App empresarial en .NET

Código público

Un monorepo de referencia. ASP.NET Core por capas, JWT con roles, PostgreSQL, React con Vite, pruebas, Docker Compose y CI.

Plataforma interna de servicio

SIESA

La plataforma tipo Jira que usan más de 500 empleados. Lidero su desarrollo y le integré tres aplicaciones internas.

Abierto a cargos remotos de tiempo completo.

Donde pueda hacerme cargo de un sistema de punta a punta, en IA, backend o datos. Estoy en Cali, Colombia, GMT-5, con el mismo horario de la costa este y el centro de EE. UU.

jessidc95@gmail.com